(上司)「AI、今月は何回使われた?」
(導入担当)「先月より増えています」
(現場)「でも、確認と手直しで前より時間がかかっています」
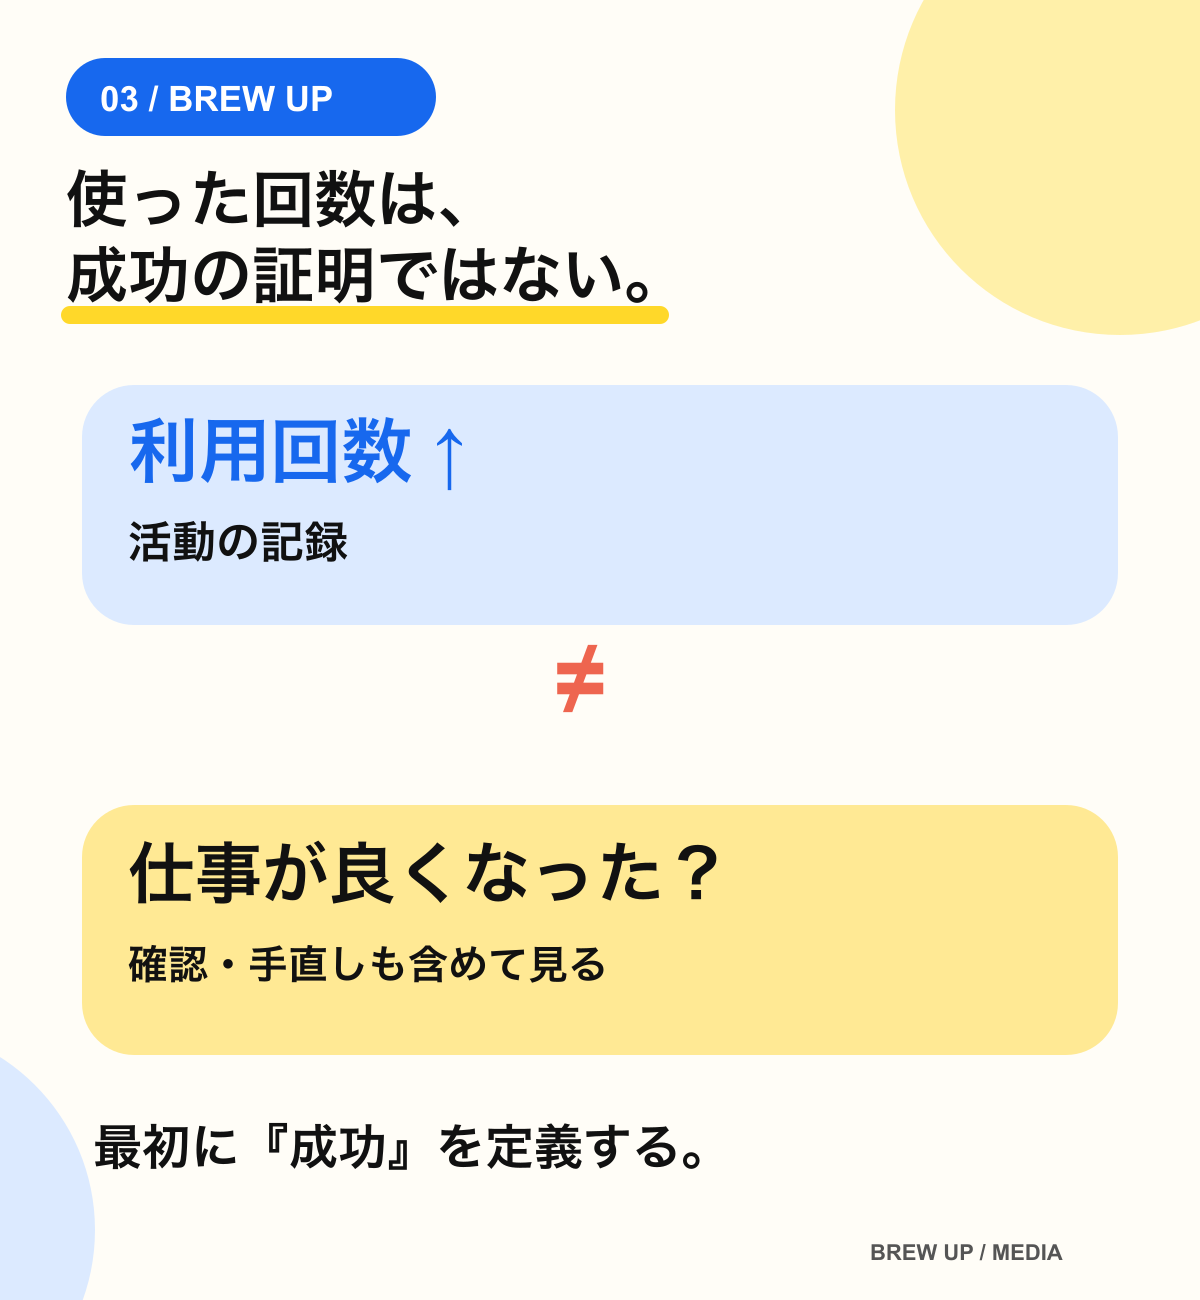
この会話、笑いごとではありません。導入を任された人ほど、利用回数のグラフを見せたくなります。目に見えるから。でも現場が欲しいのはグラフではなく、仕事が少しでも良くなったという納得です。利用回数が伸びていても、間違いを探す時間や手戻りが増えていたら、「成功」とは呼びにくい。
とはいえ、現場の「なんとなく使いづらい」だけで導入を止めるのも惜しい。どの作業が増え、どの判断が楽になり、何が使えなかったのかを見ないと、改善する場所が分かりません。使った回数は活動の記録。成功の証明ではありません。
この記事は、AI導入の報告を求められた事業・現場責任者へ書いています。全社の壮大なROI予測ではなく、まず一つの仕事で合格ラインを決め、導入前と試行中を比べる方法です。読後には、自分の現場で「継続」「修正」「中止・保留」を説明できる1業務シートが残ります。
最初の間違いは「AI導入」を測定対象にすること
「営業全体でAIを活用する」を成功条件にすると、測る範囲が広すぎます。ある人はメールを直し、別の人は提案書の骨子を作り、また別の人は議事録を要約する。入力も、完成品も、確認者も違う仕事を一つの利用回数に足しても、改善したかは分かりません。
まず一つの仕事を、始まりと終わりが見える形で選びます。たとえば「商談後の記録を整理し、次回提案で確かめる論点を下書きする」。入力は商談メモと社内で利用可能な資料。出力は、顧客へそのまま送る文章ではなく、人が確認する論点案。対象外は、顧客への自動送信と最終提案の判断です。
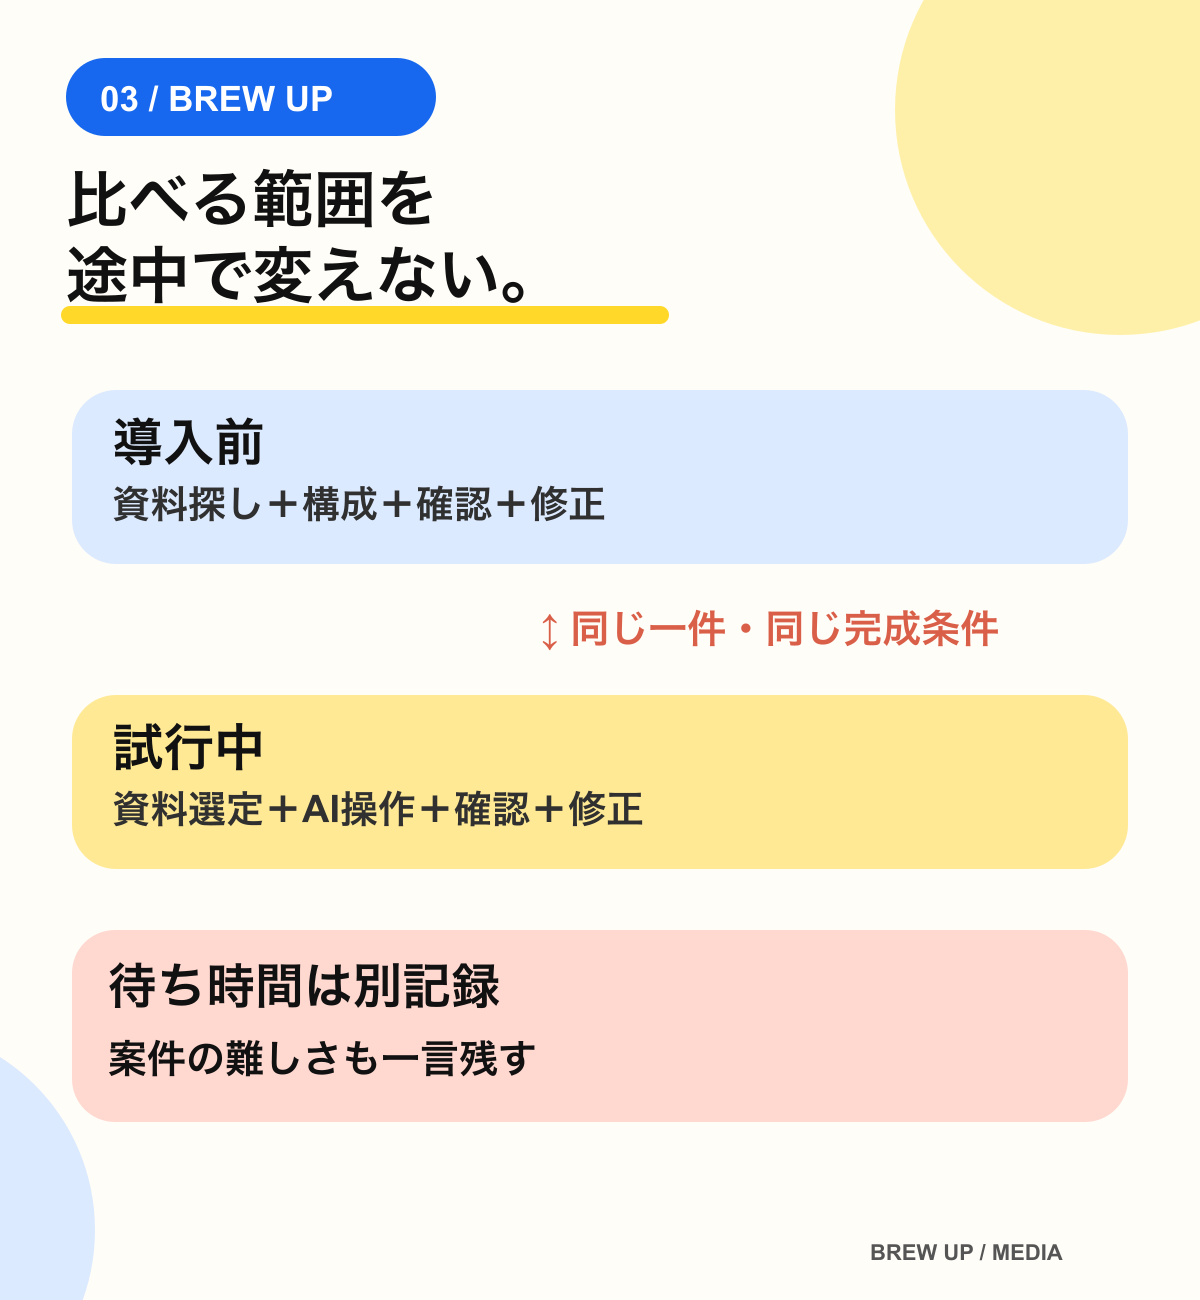
ここまで狭めて初めて、比較ができます。1回の商談を一件と数えるのか、提案一本を一件と数えるのか。着手から完成までの経過時間か、人が実際に手を動かした時間か。単位を途中で変えたら、前後の数字は比べられません。
導入前の「今」を残す。ここを飛ばすと後で詰む
導入後に「半分の時間になりました」と言いたくても、導入前の時間を測っていなければ比較できません。思い出した数字で基準値を作らないでください。今の手順で一件だけでも、開始から完了までを記録します。
記録したいのは、資料を探す時間、構成を考える時間、上長や関係者の確認時間、直しに使う時間です。待ち時間は手を動かした時間と分けます。同じ担当者でも、簡単な案件と複雑な案件では時間が違うので、案件の難しさも一言残す。導入前の一件だけで「平均」を名乗らず、まず比較の方法が成立するかを見ます。
ここで現場の人に一つ聞きます。「この仕事が終わった、と誰が判断しますか」。完成の定義が揺れていると、AIで速くなったように見えても、後工程で直しが増えます。人が使える品質と確認者まで、基準値と一緒に決めてください。
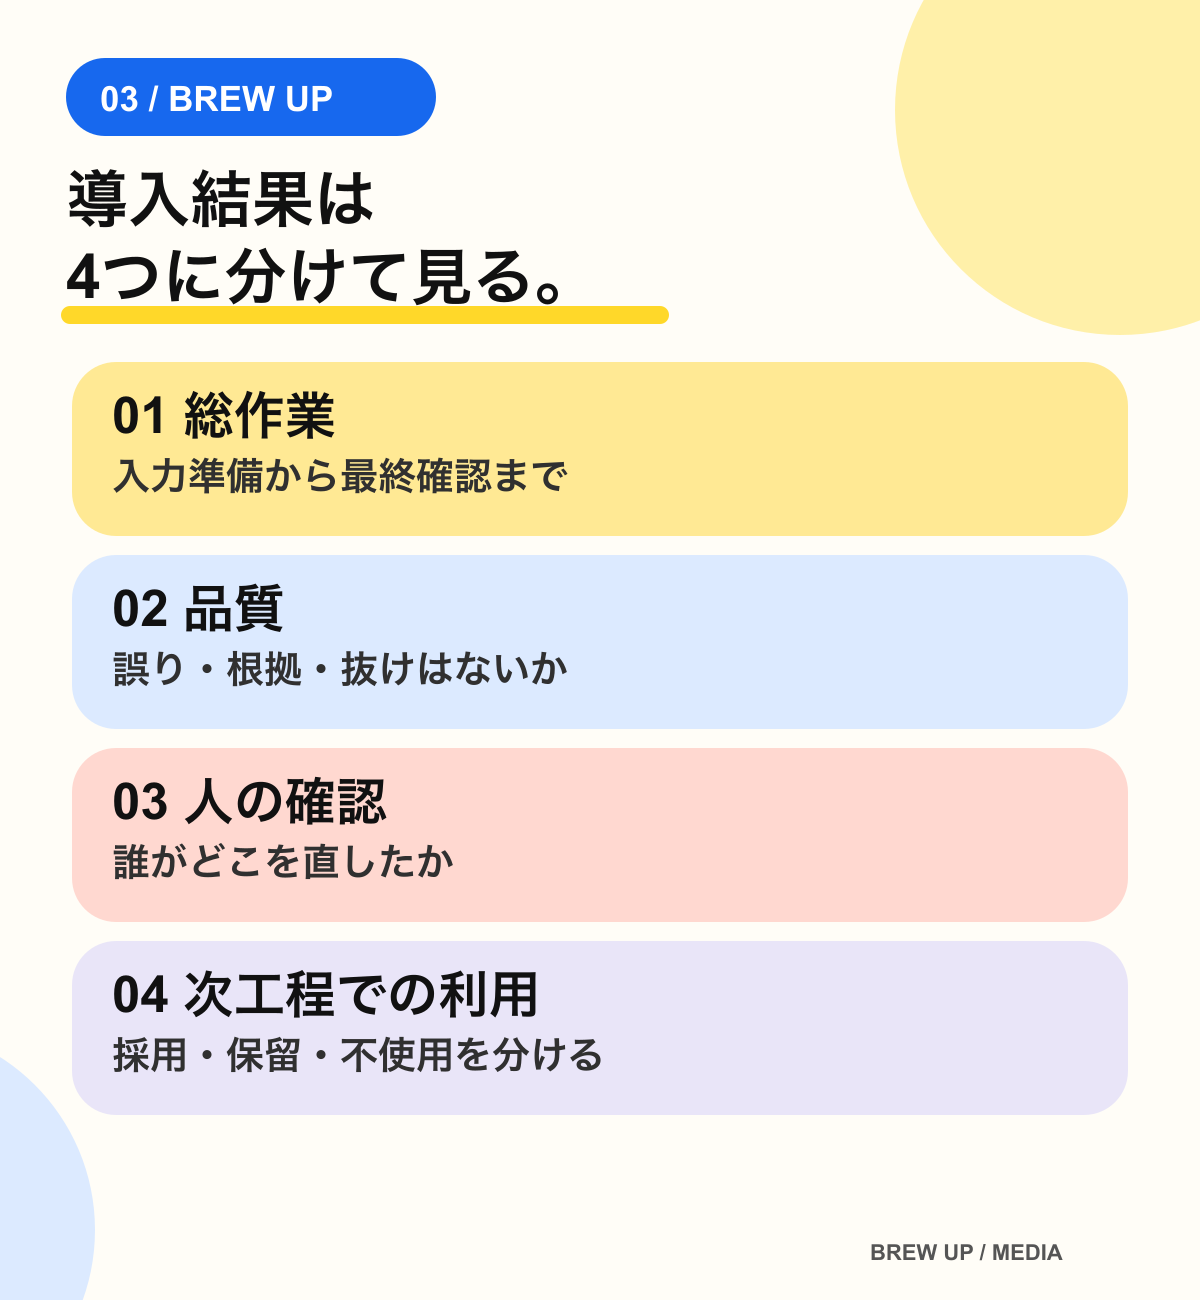
4つの観点を分ける
| 観点 | 確かめる問い | 記録例 |
|---|---|---|
| 作業 | 人が使った総時間はどう変わったか | 準備、AI操作、修正、確認を合計する |
| 品質 | 使える内容になったか | 根拠の有無、誤り、未確認事項を確認する |
| 人の確認 | 誰がどこを直したか | 修正箇所と理由を残す |
| 次工程への利用 | 実際の仕事で使われたか | 提案に採用、保留、不使用を分ける |
AIの処理時間だけを短縮分にしません。入力準備や手直しの時間も含めます。「採用された」は「受注した」と同じ意味ではありません。案件結果は別の観測として扱います。
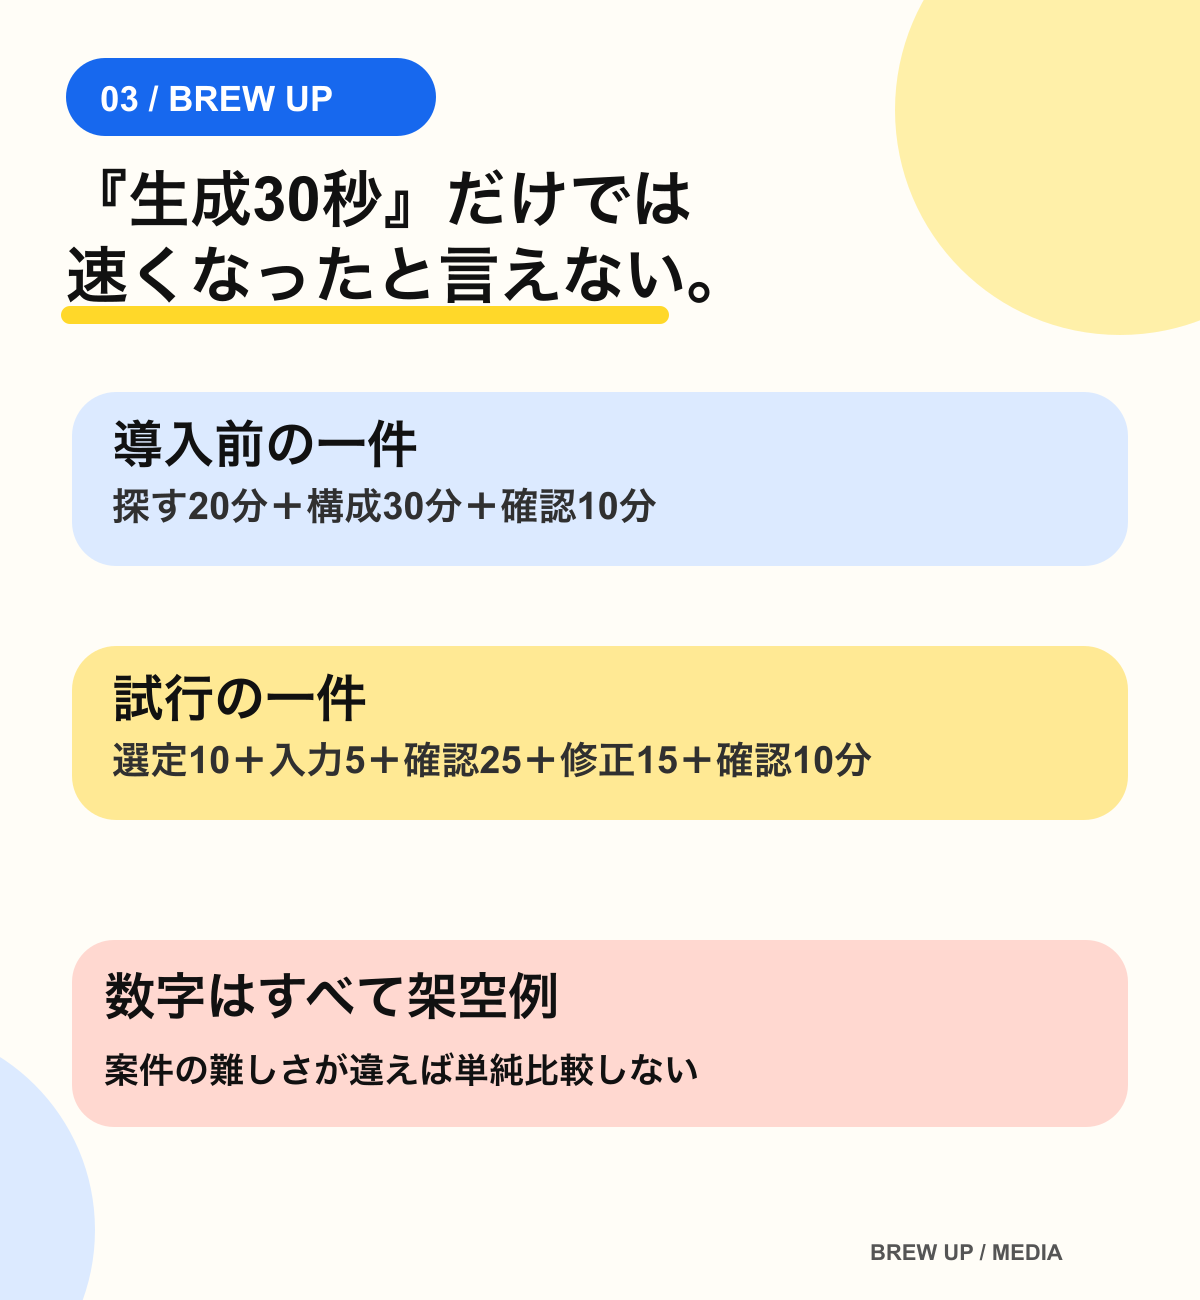
たとえばAIが30秒で下書きを出しても、入力資料を探すのに15分、事実確認に20分、書き直しに15分かかるなら、比較対象は30秒ではありません。人がその仕事を終えるまでに使った時間です。ただし、速さだけで落第にもしません。従来は見逃していた未確認事項が見えるようになったなら、品質の改善として別に評価できます。
品質は「文章が自然か」だけで判断しないでください。提案準備なら、出典のない事例、顧客の発言と推測の混同、使えない資料の引用、次回確認事項の抜けが問題になります。重大な誤りが一件でもあれば、平均時間が短くてもそのまま使わない。どの誤りを許容しないかは、試行前に現場と決めます。
人の確認は、面倒な残業ではなく設計の一部です。誰が何を確認し、どこで直したかを残すと、AIの出力だけでなく、入力資料や業務のルールに問題があるのかも見えてきます。NISTのAI Risk Management FrameworkとPlaybookも、利用状況に即した評価、測定方法の文書化、人による監督や修正の記録を扱っています。ただし、以下の4観点とシートはBREW UPの実務提案であり、NISTがこの業務の成功を保証するものではありません。1
試す前に「続ける・直す・止める」を決める
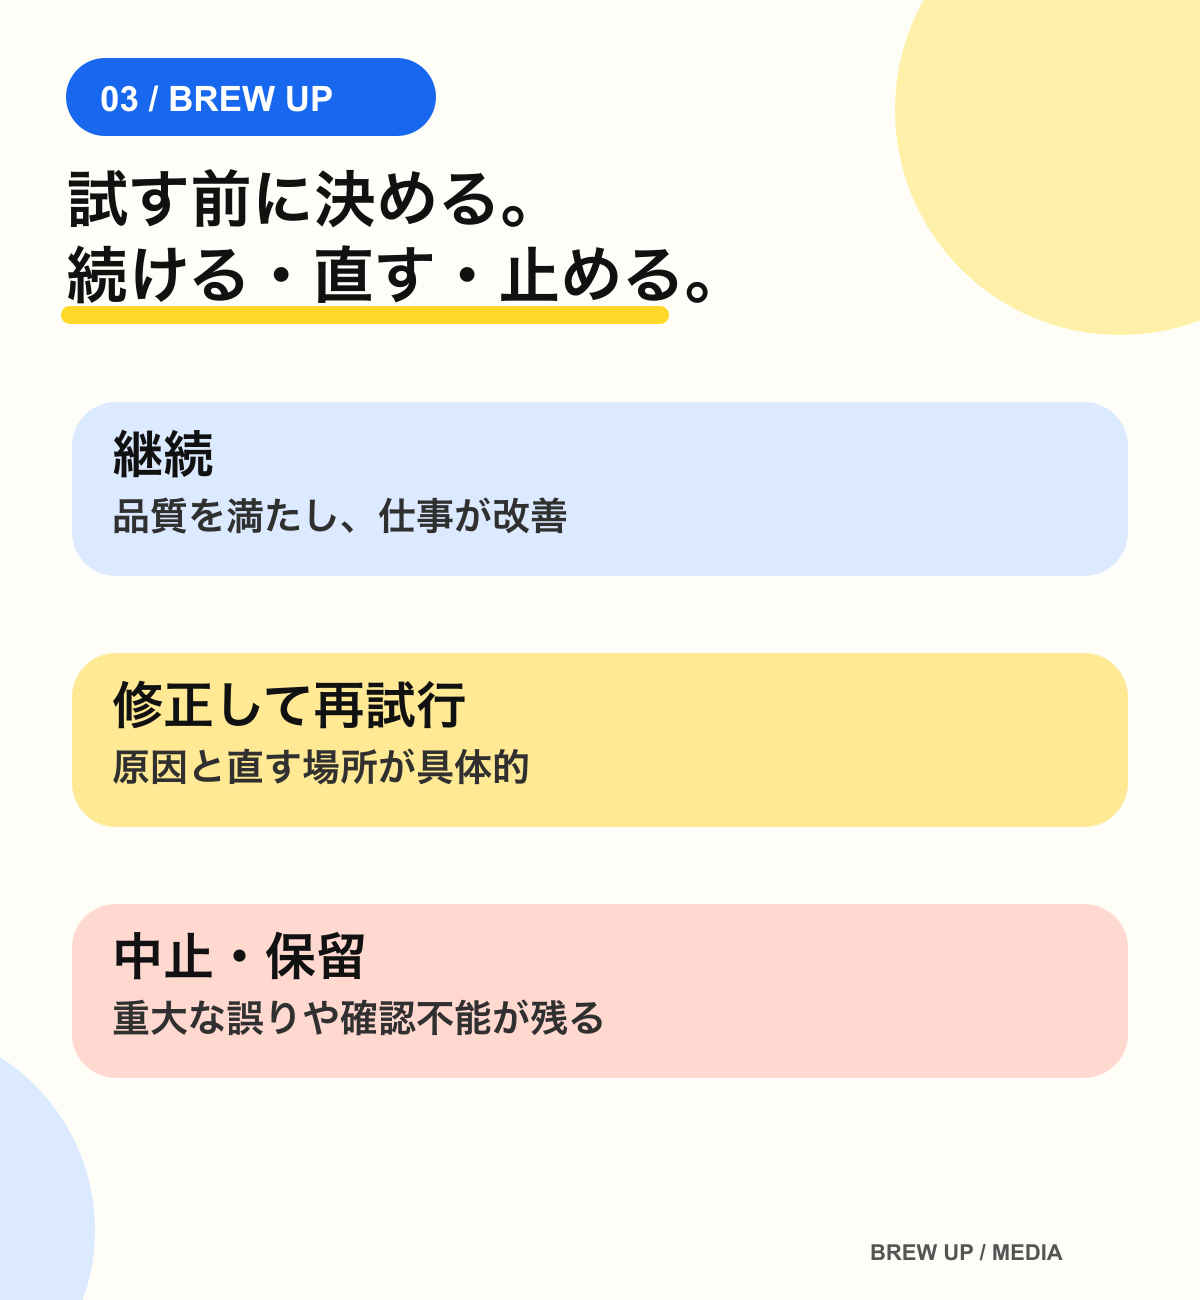
導入担当者が最も苦しくなるのは、試行後に都合のよい数字を探す時間です。回数が増えたら「浸透した」、時間が減らなければ「学習期間だから」。その場しのぎの説明にならないよう、試す前に三つの判断を決めます。
継続するのは、事前に決めた品質条件を満たし、総作業時間や次工程への利用が改善したと確認できたとき。修正して再試行するのは、改善の余地が具体的に見えたとき。たとえば引用元が古いなら参照資料を直す、確認時間が長いなら出力形式を見直す。中止・保留するのは、重大な誤りが繰り返される、必要な確認者を確保できない、許可された情報の範囲で成立しないなど、今の条件では安全に使えないときです。
「何分短縮なら合格か」という数字を、この記事から一律に持ち込まないでください。現場の仕事、品質の要求、試す件数によって変わります。まず現場と「この誤りは許容しない」「確認まで含めて、今の手順より使いやすいか」を言葉にし、必要なら数値の閾値をその業務の基準値から決めます。
架空例:提案準備を試す
以下は測定方法を示す架空例で、実測結果ではありません。対象は次回提案の骨子作成1件。導入前は、担当者が資料探し、構成、確認に使った時間と、完成稿で直された点を記録します。試行時は、資料選定、AIへの入力、下書き確認、修正、責任者の確認を同じ範囲で記録します。
たとえば導入前の一件で、資料探し20分、構成30分、確認10分だったとします。試行の一件では、資料選定10分、AIへの入力5分、出力確認25分、修正15分、責任者確認10分だったとします。この数字は説明用です。実測ではありません。 生成そのものが一瞬でも、総作業は後者の方が長い。この一件だけでAIが悪いと決めるのではなく、どの確認が増えたかを見るための記録です。案件の難しさが違うなら、時間を単純に差し引きません。
下書きが速くても、存在しない事例が混ざれば使えません。逆に時間差が小さくても、未確認事項が早く見つかれば価値があるかもしれません。その判断基準は、試行前に現場と決めます。少数の例から全社の効果を断定しません。
この架空例で出力に「存在しない顧客事例」が入っていたなら、継続の判断は止めます。原因候補は、入力資料の不足、参照できる資料の曖昧さ、出力の指示、確認手順です。まず事例を出さない設定や参照範囲の見直しを試す。修正後も同じ条件で試し、同じ誤りが残るなら、その仕事では利用を保留する。結果が悪かった理由を道具のせいにも、担当者のせいにも即決しないことが改善の出発点です。
そのまま使える1業務シート
まず、共有ドキュメントに次をコピーします。試行日と担当者を決め、導入前の一件を記録してからAIを試してください。
対象業務/1件の単位/開始と完成の定義/入力と出力/AIに任せる範囲/AIに任せない判断・送信/人の確認者/導入前の総作業と品質/試行中の総作業と品質/重大な誤りの条件/次工程で採用・保留・不使用のどれか/継続・修正・中止を決める日/判断する人
記録は「導入前」と「試行中」で同じ欄を使います。一件ずつ、作業時間、確認・修正に使った時間、品質上の問題、実際に次工程で使ったかを記入します。観測できなかった項目は0ではなく「未確認」。出力が使われなかった場合も、「品質不足」「用途が違った」「まだ次工程が来ていない」を分けます。
個人情報や顧客資料を使う場合は、所属先のルールと利用条件を先に確かめてください。実データを用いなくても、架空資料で手順と評価方法を先に検証できます。
試行後、結果をどう読めばいいか
一件の比較が終わったら、利用回数の増減より、四つの観点がどう組み合わさったかを読みます。作業は短くなったが品質が落ちたなら、時短の成功とは呼ばない。誤りが出た工程を特定し、入力と確認の設計を直します。品質は保てたが確認時間が増えたなら、どの確認が増えたかを見ます。必要な確認なら削らず、下書きの形式や参照資料を直す。不要な重複確認なら、誰が最終判断するかを整理します。
出力は良かったのに次工程で使われなかったなら、「現場がAIを嫌っている」と決めつけない。使うタイミングが遅かったのか、出力先の形式が合わなかったのか、次工程そのものがまだ来ていないのかを分けます。後者なら結果は「未観測」です。現場の手応えは良いが作業時間が増えたなら、どの品質上の価値が増えたかを言語化し、その価値に見合うか責任者と相談します。
一度の試行で全社展開を決める必要はありません。業務の種類と難しさを揃えた複数件で、同じ記録欄を使い、似た問題が続くかを見ます。何件で判断するかも、最初に現場の負担とリスクに合わせて決めます。都合の良い一件だけを選んで「成功事例」にしないためです。
そして、改善を一度に全部入れない。参照資料、出力形式、確認担当を同時に変えると、何が効いたか分かりにくくなります。原因候補を一つ選び、同じ品質条件で再試行する。結果を見て継続、再修正、保留を決める。AIの評価は、導入の発表で終わる仕事ではなく、現場の仕事を直すための判断です。
まとめと次の一歩
導入後に「使われたか」を問う前に、導入前の仕事と、何をもって使えると判断するかを残します。まず一業務・一件で、4つの観点を書き出してください。結果が悪ければ、入力資料、出力形式、確認方法のどこを直すかを一つ決める。十分に使えなければ止める判断も成果です。利用回数の報告から、仕事をどう変えるかの判断へ。 そこまでできれば、このシートは役目を果たします。
業務の選定や人の確認を含むAIエージェント設計については、株式会社BREW UPのAI AGENT / BREWMで支援内容を紹介しています。導入相談の前に、このシートだけで自社の試行条件を整理できます。
関連記事
参考資料
NIST AI Risk Management Framework 1.0 と NIST AI RMF Playbook「Measure」 を2026-10-06に確認。NISTは評価・文書化・人による監督などの論点を示す。本文の1業務シートと継続判断はBREW UPの提案。↩︎